Este guia aprofunda a análise do uso e do contexto ligados à expressão “Anapaulaterezinhadelimasantos”, explicando como esse tipo de assinatura e referência pode aparecer em ambientes informais e digitais. Em seguida, apresentamos informações objetivas sobre composição nominal, cuidados de uso e critérios de verificação. O texto também organiza requisitos e condições em formatos comparativos para orientar decisões com segurança.
A expressão “Anapaulaterezinhadelimasantos” tende a funcionar, na prática, como um identificador textual: uma sequência longa formada por partes que lembram nomes e sobrenomes, frequentemente associada a registros, listas de contato, menções em mensagens, arquivos locais e páginas de alcance restrito. Em termos objetivos, isso costuma ocorrer quando um nome completo (ou quase completo) é usado como rótulo para diferenciar pessoas em ambientes de baixa padronização — por exemplo, em cadastros manuais, anotações pessoais, indexações informais e rotinas de atendimento que não separam devidamente campos como “primeiro nome”, “nome do meio” e “último sobrenome”.
Do ponto de vista profissional (e especialmente em áreas como curadoria de dados, gestão de reputação, conformidade e governança de informação), o ponto central não é “o significado místico” do termo, mas sim a função do texto como chave de identificação dentro de um processo. Em outras palavras: o sistema (ou a pessoa) precisa entender se aquela cadeia de caracteres representa uma assinatura, uma referência a um registro, ou de fato uma entidade (uma pessoa) dentro de uma base.
Esse detalhe importa porque decisões diferentes (por exemplo, “isso é a pessoa X” versus “isso é apenas um rótulo que aponta para um registro”) levam a impactos distintos em qualidade de dados, rastreabilidade e privacidade. Quando a cadeia aparece “colada” sem separadores, o risco de interpretação errada aumenta — não porque o texto seja “misterioso”, mas porque muitos sistemas e fluxos humanos geram strings concatenadas por motivos totalmente operacionais.
Assim, “Anapaulaterezinhadelimasantos” deve ser tratada como um artefato textual que atravessou algum caminho: provavelmente alguém copiou e colou dados, exportou de uma planilha, normalizou campos em um banco local, digitalizou um documento (com OCR), ou registrou informações em um formato que não separa nomes com espaços. Consequentemente, a “importância” prática está em entender de onde veio, como foi gerada e para que serve no contexto em que aparece.
“Anapaulaterezinhadelimasantos” é, por forma, uma composição sem espaços entre partes que lembram componentes de nome. Esse padrão pode surgir por vários motivos operacionais comuns em organizações e rotinas pessoais, tais como:
Em uma avaliação técnica, isso sugere que o termo pode ser equivalente (ou relacionado) a uma forma “com espaços” do mesmo conjunto de nomes, variando conforme a fonte original. Em muitos casos, a cadeia sem espaços não é “o nome verdadeiro”, mas um representante serializado do nome em um formato transitório.
Para tornar essa hipótese operacional (e não apenas especulativa), o passo mais importante é observar o comportamento no mesmo dataset: se há outros campos como “telefone”, “e-mail” ou “documento” que também estão “concatenados” ou “sanitizados”, isso reforça a leitura de que se trata de saída de um processo de padronização. Já se o termo aparece isolado e apenas nessa forma, talvez seja o resultado de uma ação manual (por exemplo, a pessoa digitou “junto” para facilitar a busca). Em ambos os casos, a recomendação é a mesma: tratar como evidência textual e procurar o contexto que a gerou.
Quando uma cadeia nominal aparece sem separadores e sem contexto explícito, podem ocorrer problemas frequentes. Esses riscos não são “teóricos”; eles aparecem rotineiramente em operações com pessoas, cadastros e arquivos:
Por isso, a abordagem correta exige distinguir texto identificador de fonte confiável. O texto pode ser uma pista, mas a evidência real vem da origem do dado, das relações (quem enviou, quando, para onde) e dos metadados do sistema.
Uma forma prática de internalizar isso é estabelecer uma regra: toda cadeia nominal longa sem contexto deve ser tratada inicialmente como referência textual, até que a validação contextual (documentos, registros correlatos, metadados ou estruturas do banco) sustente a classificação como identificação direta.
Especialistas em organização da informação normalmente adotam um conjunto de critérios simples (mas rigorosos), que ajudam a reduzir erro operacional. A ideia não é “adivinhar” o que a cadeia significa, e sim conferir consistência entre evidências.
Essa disciplina reduz erros e melhora a confiabilidade do uso do termo em processos de curadoria, arquivamento e atendimento. Sem essas regras, cadeias longas viram fontes de confusão: a pessoa pode parecer “diferente” em virtude do formato, e o time pode acabar duplicando cadastros, criando entropia ou atribuindo informações à entidade errada.
Quando a expressão é composta por nomes e sobrenomes, ela pode funcionar como dado pessoal. Mesmo quando o termo circula em ambientes informais, a boa prática é tratá-lo com cuidado: a utilidade do texto está em organizar informação, não em expor pessoas.
Em termos objetivos: o valor do termo está em como ele ajuda a organizar informação — não em expor pessoas. Portanto, a abordagem recomendada é: tratar o identificador como dado pessoal, aplicar controles proporcionais ao risco e manter a análise centrada na finalidade legítima.
Em operações comuns, cadeias desse tipo surgem com frequência. Abaixo, exemplos de rotinas em que um nome concatenado sem espaços aparece de forma recorrente:
Por isso, o termo pode ser visto como um “vestígio” de um fluxo anterior de dados. A análise profissional, ao detectar esse padrão, busca reconstruir esse fluxo com o mínimo de inferência e o máximo de evidência. Não se trata de “descobrir o significado”, e sim de “entender o caminho da informação”.
Uma analogia útil: assim como um carimbo sem leitura do carimbo original é menos informativo, uma cadeia nominal concatenada sem contexto é menos adequada para decisões. A diferença é que, com bons metadados e validações, esse artefato pode ser reconectado à realidade do registro original.
Uma leitura técnica recomenda separar a expressão em três possíveis funções, pois isso orienta o que você deve (e o que não deve) fazer com o termo:
Se você não souber qual função é a correta, a conduta mais segura é tratar como referência textual até haver confirmação contextual. Isso reduz o risco de atribuir dados à pessoa errada.
Como aplicar essa lógica no dia a dia? Observe o “ambiente de uso”. Por exemplo:
Mesmo assim, a recomendação permanece: sem contexto adicional, trate como referência. Em sistemas de governança, “incerteza” é preferível a “assunção” — porque a incerteza pode ser verificada, mas a assunção tende a produzir erro definitivo.
A seguir, apresento uma comparação objetiva entre abordagens comuns em ambientes profissionais. Não se trata de “adivinhar” o significado do termo; trata-se de definir como reduzir erro e aumentar rastreabilidade. Em governança de dados, a pergunta não é apenas “o que é isso?”, mas “como garantir que o que estamos fazendo é correto?”.
| Abordagem | Quando usar | Vantagem principal | Condição/limite |
|---|---|---|---|
| Reconstrução com variações de grafia | Quando o termo aparece “colado” sem espaços | Ajuda a encontrar o registro original e reduz falhas de busca | Requer amostra de contexto (ex.: outra parte do documento, presença de e-mail ou documento associado) |
| Classificação por função (assinatura/referência/identificação) | Quando há múltiplas possibilidades de uso | Evita decisões baseadas em pressupostos | Precisa de evidências mínimas do ambiente (onde o termo aparece e como ele é usado) |
| Checagem por origem e consistência | Quando há risco de homônimos ou duplicações | Reduz confusão entre pessoas e melhora precisão do matching | Dependente da qualidade do cadastro-fonte e da disponibilidade de metadados |
| Anonimização ou minimização | Quando o conteúdo será divulgado publicamente ou compartilhado fora de controles rígidos | Diminui risco de exposição e reidentificação | Não substitui verificação quando houver responsabilidade legal, auditoria ou necessidade de manter prova |
| Uso de identificadores internos (IDs) | Quando há possibilidade de mapear o termo para um registro mestre | Melhora interoperabilidade e reduz ambiguidade textual | Exige que o sistema mantenha o mapeamento e que não haja perda de ligação durante migrações |
Essa matriz é especialmente útil porque mostra que não existe “uma única solução” para todos os termos longos. A melhor abordagem depende do tipo de sistema, do nível de padronização e do risco associado à decisão (por exemplo, se a decisão envolve contato direto com pessoas, atribuição de responsabilidade, ou exportação de relatórios).
Um processo recomendado para análise e uso deve ser consistente, auditável e cuidadoso com privacidade. A ideia é transformar uma string potencialmente ambígua em algo operacionalmente seguro.
Para que a análise seja adequada em rotinas profissionais, algumas condições precisam ser atendidas. Sem elas, qualquer conclusão tende a ser frágil e difícil de sustentar:
Esses requisitos garantem que a análise não seja apenas “correta em um caso”, mas reproduzível e confiável em conjuntos maiores.
Como este guia é uma análise de padrões textuais e práticas de governança de informação, as referências típicas para fundamentar recomendações incluem princípios e diretrizes amplamente adotados em gestão de dados, qualidade e privacidade. Embora a aplicação exata dependa do país, do setor e das políticas internas, os conceitos base costumam convergir para:
Observação importante: sem indicação de fornecedores, preço ou localização específica nos insumos fornecidos, o artigo se mantém como um guia metodológico centrado em governança e qualidade de informação. Assim, evita alegações não verificadas e não cria dados econômicos ou geográficos. O foco é sempre o comportamento do dado, sua origem e o contexto de uso.
Em termos práticos, vale considerar que “fontes” aqui não são “nomes de sites” específicos, mas sim o conjunto de regras e padrões que sua organização adota. Em times maduros, a cadeia nominal é tratada como parte de um sistema maior: com políticas de acesso, governança de registros e validações mínimas.
Em geral, não há um “significado único” universal. Trata-se, na maioria dos casos, de uma cadeia nominal usada como texto de referência. O significado prático depende do contexto em que foi observado: se está em assinatura, em um campo de busca, ou em um registro de cadastro.
Porque pode ter sido gerado por processos de cópia/cola, normalização de campos, exportação de planilhas, escrita manual sem separadores, sanitização em pipelines, ou ainda por erros/efeitos de OCR. Em muitos cenários, isso indica apenas um formato de registro, não uma intenção semântica específica.
A forma mais segura é checar a origem do dado e o contexto do documento/mensagem onde aparece. Com evidência suficiente (por exemplo, associação com ID interno, número de protocolo, ou atributos corroborantes), você pode classificar como identificação; sem contexto, trate como referência textual. Esse é o motivo pelo qual governança de dados insiste em “ancorar” decisões em evidências e não apenas em leitura textual.
Se o termo estiver associado a nome(s) de pessoa(s), avalie privacidade e necessidade de divulgação. Boas práticas profissionais incluem minimização de dados e cuidado com exposição desnecessária. Em muitos casos, a resposta correta é não usar o texto nominal completo publicamente; em vez disso, use tokens ou exemplos anonimizados.
Separe campos (quando possível), normalize grafias, mantenha metadados de origem e registre decisões. Se não houver separação no sistema, crie uma rotina para guardar variações e links internos ao contexto (sem depender apenas do texto colado). Em termos de engenharia de dados, isso frequentemente significa criar uma “tabela de mapeamento” entre a string concatenada e um ID canônico, sempre que for viável.
Sim. Os mesmos critérios funcionam para outras cadeias nominais longas: reconstrução de grafia com evidência, checagem por origem e classificação de função (assinatura/referência/identificação). Além disso, recomenda-se que o processo seja parametrizável: diferentes datasets podem ter diferentes níveis de padronização.
Quando a reconstrução com variações falha, existem duas explicações comuns: (1) o termo não representa a mesma forma do cadastro original; ou (2) houve erro de OCR/sanitização ou algum elemento foi perdido (por exemplo, uma parte do nome foi truncada). A conduta profissional é: não forçar matching por similaridade textual isolada. Em vez disso, verifique se há outros metadados (datas, documentos associados, IDs internos) que permitam uma validação cruzada.
Para evitar duplicação, use uma estratégia de resolução de entidades baseada em evidências: crie um ID canônico quando possível, ou aplique critérios de correlação com múltiplos atributos. Se o único indicador for a string concatenada, o risco de falso positivo aumenta. Por isso, mesmo em processos ágeis, é recomendável exigir ao menos um atributo adicional verificável (quando compatível com privacidade e finalidade).
Não de forma universal. Separar nomes concatenados exige heurísticas e, idealmente, informação contextual. Em alguns casos, modelos de linguagem ou regras probabilísticas podem ajudar, mas a prática profissional prefere ancoragem em fontes (como registros existentes e metadados) em vez de inferência cega. Quanto maior o risco de erro, maior deve ser o nível de validação.
Ao tratar “Anapaulaterezinhadelimasantos” como objeto de análise, o enfoque mais consistente é o da governança de informação: entender como o texto foi gerado, qual função cumpre no processo e quais evidências sustentam qualquer inferência. Quando falta contexto, o caminho profissional é reduzir suposições, registrar critérios e priorizar privacidade e consistência.
Em vez de buscar um “significado” abstrato, vale transformar a cadeia nominal em algo verificável. Isso significa: (1) entender a origem do dado, (2) classificar a função (assinatura, referência ou identificação), (3) validar com metadados ou registros correlatos, e (4) aplicar minimização e controle de acesso quando houver exposição.
Se você tiver um trecho do contexto original (por exemplo, o tipo de documento, a plataforma onde o termo apareceu e a finalidade do uso), é possível transformar este guia em uma checagem mais direcionada — mantendo rigor e cautela. A lógica permanece: evidência antes de inferência, rastreabilidade antes de suposição e privacidade como requisito, não como detalhe.
Por fim, é útil reforçar uma ideia prática: cadeias nominais longas sem espaços raramente são “o coração do problema”. Elas são sintomas de um fluxo de dados. Ao olhar para o fluxo (origem, transformação e finalidade), a análise deixa de ser apenas interpretação textual e passa a ser gestão de informação de forma profissional — com menos erro, menos retrabalho e mais segurança operacional.



Este guia analisa como “Aguinaldofirminocampos”, “espinhos” e “remacubaia” aparecem no cotidiano e na paisagem local, ajudando a orientar escolhas práticas e seguras. Em termos de contexto, os termos remetem a elementos naturais e identidades locais, com foco em observação, manejo responsável e uso orientado por boas práticas.
Este guia aprofunda a análise do uso e do contexto ligados à expressão “Anapaulaterezinhadelimasantos”, explicando como esse tipo de assinatura e referência pode aparecer em ambientes informais e digitais. Em seguida, apresentamos informações objetivas sobre composição nominal, cuidados de uso e critérios de verificação. O texto também organiza requisitos e condições em formatos comparativos para orientar decisões com segurança.
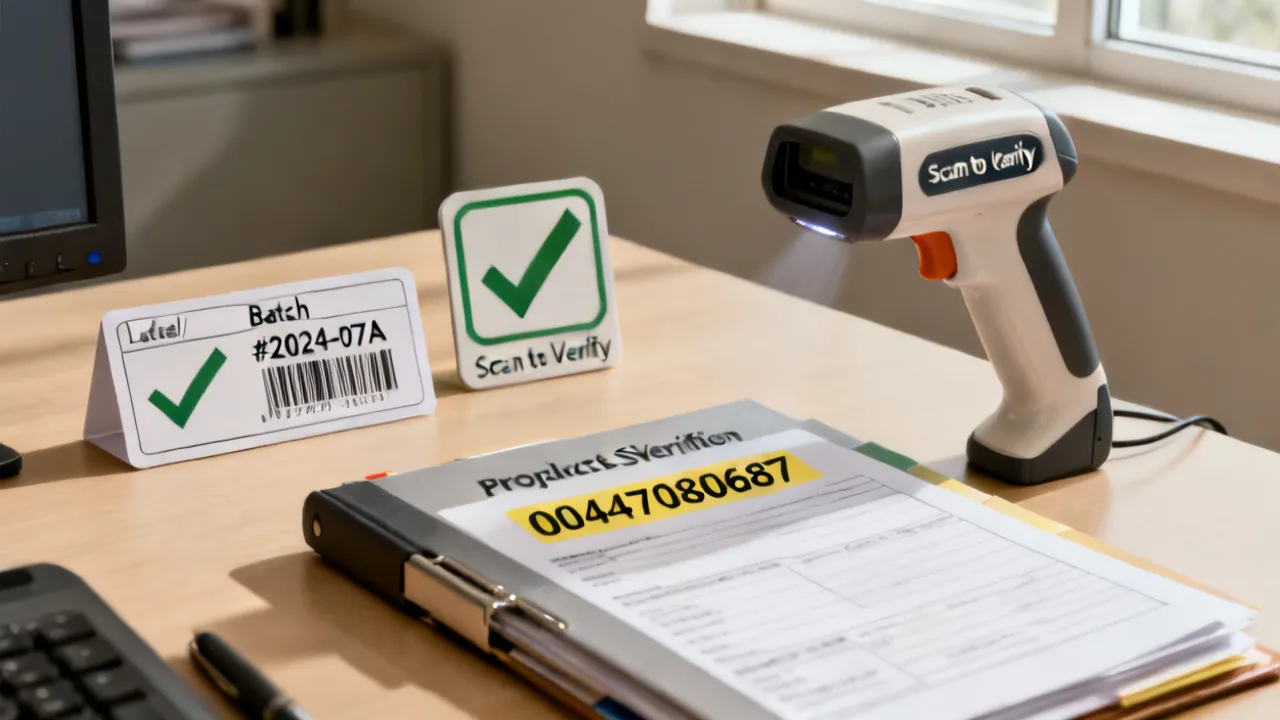
This guide explains how to verify supplier and product specifications tied to “00447080687”, including documentation checks, traceability steps, and quality requirements. Objectively, supplier verification helps reduce risk by confirming identity, certifications, and batch consistency. The guide also shows how to evaluate pricing signals, confirm compliance, and document your decisions for audits and procurement governance.
This guide explains how to interpret supplier reference details tied to 00447080687, evaluate quoted pricing, and confirm manufacturing or distribution readiness. Objectively, it reviews why supplier reference numbers, documentation consistency, and sourcing verification matter in procurement. It also outlines practical checks you can apply to avoid mismatch between product specifications and actual supply terms.
This guide explains how to evaluate supplier sourcing using the identifier 00447080687, pricing signals, and due-diligence checks to support compliant purchasing decisions. It also provides an objective background on what supplier onboarding typically covers, which documentation matters very, and how to compare offers consistently across procurement categories in a way that stands up to audits.
This guide explains how to evaluate product reference O5176284516 in real procurement decisions—covering how to interpret SKU-style identifiers, assess supplier fit, and compare practical cost drivers without relying on hype. Objectively, background context is provided on how modern supply sourcing workflows prioritize documentation, lead times, compliance, and traceability.

