Esta guía explica cómo evaluar e implementar Commander Hibrido en entornos de control híbrido, con enfoque en criterios técnicos, riesgos y buenas prácticas operativas. El texto contextualiza, de forma objetiva, qué implica “híbrido” en mandos y comunicaciones, cómo se integra con sistemas existentes y qué requisitos suelen pedir los equipos de ingeniería para asegurar compatibilidad, seguridad y trazabilidad.
Si tu objetivo es consolidar el control de operaciones mediante una estrategia “híbrida”, Commander Hibrido suele presentarse como una opción orientada a la coordinación entre capas (por ejemplo, automatización, supervisión y comunicaciones), permitiendo que el sistema no dependa de un único mecanismo de control. En términos de ingeniería, lo importante no es solo “que funcione”, sino cómo se integra, qué supuestos incorpora y qué responsabilidades transfiere a cada componente. Esta guía te ayudará a tomar decisiones con criterio, ordenando la evaluación por prioridades: compatibilidad, seguridad, continuidad operativa, mantenimiento y gobernanza de datos.
Sin embargo, para que el análisis técnico sea realmente útil, conviene partir de una idea básica: “híbrido” no es un adjetivo que garantice calidad por sí mismo. Puede significar desde una simple combinación de módulos hasta una arquitectura de coordinación compleja con garantías estrictas sobre estados, seguridad y respuesta ante fallos. Por eso, cuando se evalúa Commander Hibrido, el enfoque no debería ser “¿cumple requisitos funcionales?” sino “¿cumple requisitos de comportamiento y garantías bajo condiciones reales?”.
En la práctica, los problemas que aparecen en proyectos de control rara vez se explican por “falta de features”. Más bien surgen por desalineaciones: el operador espera una semántica de comandos distinta a la del sistema; el integrador asume un modelo de estados que no coincide con el diseño; el sistema de comunicaciones no está dimensionado para latencias reales; o la seguridad se implementa de forma superficial sin auditoría efectiva. Un análisis técnico riguroso permite detectar esas brechas antes de que se materialicen como incidentes operativos.
Además, Commander Hibrido suele tocar componentes críticos: configura reglas, valida condiciones, coordina flujos y puede llegar a ejecutar o habilitar acciones con impacto físico o lógico. Cuando un componente concentra la lógica de decisión, se convierte en un punto de control que requiere gobernanza, pruebas y trazabilidad. Por ello, el valor del análisis técnico está en que convierte una “promesa” de arquitectura en un conjunto verificable de comportamientos y controles.
Para construir ese análisis con orden, es útil considerar el ciclo de vida completo: diseño, integración, pruebas, puesta en marcha, operación, mantenimiento y cambios. Cada etapa introduce preguntas distintas. En diseño, la pregunta suele ser “qué puede pasar y qué garantiza el sistema”; en integración, “cómo se conectan interfaces y semánticas”; en pruebas, “qué evidencias tenemos”; en operación, “cómo respondemos ante anomalías”; y en mantenimiento, “cómo controlamos cambios sin romper compatibilidad”.
En el contexto de sistemas de mando, “híbrido” suele referirse a la coexistencia de diferentes enfoques o capas de control. Dependiendo del fabricante y del proyecto, puede implicar una combinación de:
Así, Commander Hibrido se entiende top como una capa coordinadora que unifica criterios de operación, evitando que cada subsistema “negocie” por su cuenta las decisiones críticas. Este enfoque, bien implementado, facilita que el equipo disponga de una línea de mando coherente, con menos ambigüedad operativa.
Ahora bien, la palabra “coordinación” tiene implicaciones técnicas. Coordinar no es únicamente “enviar comandos”. Coordinar significa:
Por eso, para analizar Commander Hibrido, conviene mirar más allá de la capa conceptual. La arquitectura real debe especificar interfaces, ciclos de ejecución, estrategias de sincronización, mecanismos de control de errores y políticas de seguridad. En un verdadero sistema híbrido, cada componente “sabe” cuál es su responsabilidad: por ejemplo, la automatización produce decisiones o acciones bajo condiciones; la supervisión valida, registra y mide; y la capa coordinadora orquesta el flujo y define cuándo una decisión está habilitada.
También es común que “híbrido” se use como sinónimo de “multi-canal” o “multi-protocolo”. En ese caso, el desafío técnico es que la coordinación se mantiene incluso cuando cambian las condiciones del canal (por ejemplo, comunicaciones intermitentes). Un comandante híbrido bien diseñado incluye mecanismos para no asumir que todos los subsistemas responden inmediatamente ni que los mensajes llegan en el mismo orden. Sin ese cuidado, el “híbrido” puede convertirse en un amplificador de errores.
Desde una perspectiva de ingeniería de sistemas, el mayor riesgo rara vez es la ausencia de funcionalidad; suele ser la desalineación entre expectativas del usuario, capacidades reales del sistema y condiciones del entorno. A continuación, los puntos que más influyen en proyectos donde se pretende integrar un comandante híbrido:
Un sistema puede “encajar” en términos generales y fallar en detalles: tipos de entradas/salidas, latencias, modo de direccionamiento, formatos de datos, ciclos de ejecución y comportamientos ante fallos. Para Commander Hibrido, la compatibilidad debe verificarse a nivel de:
En instalaciones reales, la compatibilidad es mucho más que “conectar cables o APIs”. Por ejemplo, un subsistema puede publicar un estado con un retardo inherente (porque su medición proviene de un sensor con filtro temporal). Si el comandante híbrido toma decisiones con base en esos estados sin considerar el retardo o su “edad” (age of information), podría tomar decisiones equivocadas. Por eso, es recomendable exigir o implementar información de:
Otro punto clave es la compatibilidad de semántica. Dos subsistemas pueden tener un “comando de arranque”, pero uno puede interpretarlo como “habilitar el modo” y el otro como “ejecutar inmediatamente”. Si el comandante híbrido no define claramente cuál es la semántica esperada, la coordinación se vuelve ambigua. La mitigación consiste en documentar y acordar una contratación de interfaces (interface contract) con ejemplos concretos y casos de error.
Además, la compatibilidad con infraestructura existente también incluye compatibilidad con operación. Por ejemplo: ¿los operadores están acostumbrados a que ciertas señales “interlock” estén presentes para habilitar el arranque? ¿El comandante híbrido añade un nuevo paso de confirmación? Si sí, debe quedar entrenado el personal y deben actualizarse los procedimientos de operación para evitar que se interprete como “falla” lo que es un flujo nuevo pero esperado.
Un comandante de control, por diseño, concentra decisiones. Eso lo vuelve un objetivo natural para medidas de seguridad. Sin exagerar, la práctica profesional exige que el proyecto contemple:
Para un marco de referencia, es habitual apoyarse en estándares de gestión y aseguramiento de sistemas (p. ej., prácticas de seguridad para control industrial y gestión de riesgos). Cuando evalúes Commander Hibrido, busca que el diseño sea auditable y que el equipo pueda operar con evidencias.
En seguridad, un error común es considerar únicamente la capa de autenticación “cuando se inicia sesión” y olvidar que el comandante híbrido toma decisiones durante el ciclo operativo. Por ejemplo, si existe una transición de modo que requiere “doble aprobación” o confirmación, el sistema debe garantizar que el flujo sea verificable y registrado. Si solo se muestra en pantalla sin registro detallado, la auditoría no cumple su función.
También conviene evaluar la seguridad de la configuración. Un comandante híbrido puede tener reglas de transición, umbrales y secuencias. Si esos parámetros se editan o despliegan sin control de integridad (hashes, firmas, checksums) o sin un historial de cambios, el sistema se vuelve vulnerable a corrupción accidental y, en algunos escenarios, a cambios no autorizados. Mitigar implica:
Además, debe definirse cómo se protege la comunicación entre capas. “Protección de integridad” no es solo cifrado; puede incluir:
Un sistema híbrido “maduro” no solo opera: explica por qué operó como operó. En la práctica, esto significa:
El diagnóstico en un comandante híbrido es particularmente importante porque la coordinación puede introducir “causas” indirectas. Por ejemplo, el sistema puede rechazar un comando porque una capa de supervisión no validó un prerequisito. El operador podría ver el rechazo sin entender que el motivo está en un estado previo o en un dato con calidad insuficiente. Si el sistema entrega diagnósticos incompletos, el equipo entra en ciclos de prueba y error manual.
Para mejorar el diagnóstico, se recomienda exigir que los mensajes incluyan:
Asimismo, un comandante híbrido que no ofrece trazabilidad dificulta la depuración post-incidente. Si el sistema no registra correlación entre comando, respuesta y eventos internos, el equipo no puede reconstruir la secuencia y el incidente se convierte en un problema “no determinista” (o pseudo-no determinista) que se repite sin explicación. Mitigar esto exige un diseño de observabilidad (logging, metrics, tracing) que permita reconstrucción.
La integración de un comandante híbrido raramente se resuelve con “conectar y listo”. En proyectos de ingeniería, se trabaja en etapas para reducir incertidumbre. Aunque cada instalación tiene particularidades, un itinerario típico para Commander Hibrido incluye:
Antes de tocar infraestructura, define con claridad qué se entiende por “éxito”. Por ejemplo:
En esta etapa, es recomendable convertir requerimientos “en texto” en requerimientos “verificables”. Por ejemplo, si un requerimiento es “el sistema debe reaccionar rápido”, hay que traducirlo a métricas: tiempo máximo aceptable para transición de estado, para rechazo de comando o para activación de parada segura (si aplica). Si el proyecto no tiene cifras desde el inicio, puedes aproximarlas con base en:
También es útil definir escenarios. Un enfoque por casos de uso permite detectar fallas de coordinación antes de la integración. Algunos escenarios típicos son:
El corazón de un sistema de mando híbrido es el flujo entre estados. Deberías documentar:
En arquitectura lógica, conviene además definir reglas de consistencia. Por ejemplo, si una capa de automatización tarda en responder, el comandante híbrido debe decidir si “mantiene el estado esperado”, si entra en estado “en progreso”, o si aplica una política de timeout. Cada decisión tiene impacto en la experiencia del operador y en la seguridad.
Un modelo útil de diseño incluye:
Este desglose evita un problema típico: cuando el sistema trata “orden” y “confirmación” como si fueran inmediatas. En un entorno híbrido, a veces hay pasos intermedios que pueden fallar. Por ejemplo, la automatización puede aceptar un comando pero la confirmación desde supervisión puede no llegar por un problema de comunicación. El comandante híbrido debe manejar esa incertidumbre.
La mitigación es introducir un concepto de incertidumbre gestionada. El comandante debe registrar que una acción fue “enviada” pero no “confirmada”, y definir qué significa operar mientras la confirmación no llega. Dependiendo de la criticidad, puede:
En resumen, el diseño del modelo de estados debe ser tan exhaustivo que el sistema no pueda caer en “estados huérfanos” (por ejemplo, un estado intermedio no contemplado que aparezca por una condición no prevista). Para lograrlo, conviene hacer revisión de estados con herramientas de modelado o al menos con revisiones estructuradas y listas de verificación.
En sistemas híbridos, muchas fallas nacen en la comunicación o en supuestos implícitos. Evalúa:
Un plan de comunicaciones debe considerar:
En particular, el comandante híbrido debe estar preparado para:
Para mitigar, se puede implementar un mecanismo de correlación entre eventos (por ejemplo, identificadores de comando, correlación y secuencias). Con esos identificadores, la capa coordinadora puede detectar “mensajes de otro ciclo” o “respuestas tardías de un intento anterior”. Esto reduce el riesgo de que el sistema interprete una confirmación vieja como si fuera actual.
Otro elemento útil es definir políticas de “degradación por comunicaciones”. Por ejemplo: si el enlace de supervisión falla, el comandante híbrido podría:
La validación debe ser medible. Un proyecto serio define pruebas como:
Para que las pruebas sean realmente útiles, deben incluir criterios de aceptación que describan “qué es correcto”. Por ejemplo:
También es recomendable considerar pruebas de “regresión” cuando se actualice configuración o lógica. En sistemas híbridos, un cambio que parece menor (por ejemplo, ajustar un umbral) puede alterar rutas de transición y afectar condiciones de seguridad. Por eso, deben definirse suites de pruebas repetibles.
Asimismo, una práctica profesional es incluir pruebas de “observabilidad”: verificar que los logs y métricas permiten reconstruir el flujo completo. Por ejemplo, si el comando fue rechazado, el sistema debería registrar:
Sin esa evidencia, las pruebas pueden ser “verdes” a nivel de funcionalidad pero “rojas” a nivel de diagnóstico y auditoría.
Una puesta en marcha responsable incluye una etapa de operación asistida, con personal preparado para:
En despliegue controlado, conviene planificar:
Una buena práctica es definir “límites de seguridad” durante el arranque. Por ejemplo, si el sistema detecta un patrón anómalo de timeouts o rechazos, puede bloquear ciertas funciones automáticamente o requerir intervención. Esto evita que el comandante híbrido se comporte con lógica “funcional” pero operativamente peligrosa bajo condiciones reales.
Durante operación asistida, es importante que el equipo aprenda a interpretar los estados del comandante. Un estado como “degradado” no debe percibirse como “falla sin contexto”. Debe tener un significado operativo claro: qué operaciones siguen permitidas, qué operaciones están bloqueadas y qué acciones de recuperación se recomiendan.
Para complementar lo anterior, aquí tienes un comparativo orientado a criterios. No incluye enlaces; se centra en requisitos que suelen solicitarse al evaluar un comandante híbrido como Commander Hibrido.
| Área | Qué se compara | Condiciones/ requisitos típicos |
|---|---|---|
| Compatibilidad | Integración con subsistemas existentes | Soporte de formatos/protocolos; mapeo de señales; manejo de estados y sincronización. |
| Seguridad | Control de acceso y trazabilidad | Roles y permisos; auditoría de eventos; protección de integridad de configuración y mensajes. |
| Confiabilidad | Comportamiento ante fallos | Degradación controlada; timeouts; recuperación; estrategia ante pérdida parcial de comunicación. |
| Diagnóstico | Capacidad de depuración | Registros detallados; mensajes accionables; herramientas para revisión de secuencias y estados. |
| Mantenibilidad | Gestión de cambios | Control de versiones; procedimientos de actualización; pruebas de regresión; documentación técnica. |
Para ampliar la utilidad de esta tabla, conviene agregar criterios “transversales” que a menudo se olvidan. Por ejemplo, muchos proyectos fallan no por compatibilidad directa, sino por:
Si necesitas una secuencia práctica para avanzar con orden, usa este esquema. Está formulado como una guía general (puede adaptarse a tu contexto) y asume que tu equipo busca evitar improvisación.
A ese esquema base, puedes agregar “capas” de calidad para que el proceso sea repetible y auditable. Por ejemplo, en proyectos donde Commander Hibrido integra múltiples subsistemas, conviene formalizar:
Otro punto que suele subestimarse es la gestión de dependencias entre subsistemas. Un comandante híbrido puede depender de datos de supervisión para habilitar decisiones. Si esos datos dependen de un subsistema externo que puede reiniciarse, el comandante híbrido debe tener un comportamiento claro cuando se detecta la “ausencia” o “desconexión” de esa fuente. Por lo tanto, dentro del alcance de interfaces, conviene especificar eventos como:
Y, desde el lado de operación, conviene actualizar procedimientos para que el equipo no “salte” capas. Por ejemplo: si el comandante híbrido exige confirmación, el operador no debería intentar operar en paralelo mediante acciones directas en subsistemas, porque podría romper el modelo de estados coordinado. La gobernanza operativa debe contemplar esa regla.
Para reducir riesgos, conviene exigir condiciones mínimas. Aquí no hablamos de “garantías absolutas”, sino de prácticas profesionales verificables.
Para que estas condiciones tengan peso real, es recomendable que estén conectadas a evidencias. Por ejemplo, “pruebas documentadas” debe incluir:
Un plan de respuesta a incidentes también debe especificar roles y decisiones. En un sistema híbrido, un incidente puede ser técnico (latencia o pérdida de mensajes), funcional (rejeción de comando por prerequisito) o de seguridad (intento de acceso no autorizado). Dependiendo del tipo, el equipo debe saber:
En monitoreo y métricas, además de “estado general”, considera métricas específicas que reflejen el comportamiento del comandante híbrido:
Con esas métricas, puedes detectar degradación antes de que se convierta en un incidente mayor. Por ejemplo, un aumento gradual de timeouts puede indicar saturación de red o problemas intermitentes de hardware. Detectarlo temprano permite actuar sin llegar a una parada.
Finalmente, la capacitación es fundamental. En sistemas híbridos, la forma de interpretar estados y alarmas cambia. El personal operativo necesita comprender:
En entornos donde se introduce Commander Hibrido, el proveedor suele aportar documentación, soporte técnico y configuración de referencia. Sin embargo, el cliente (o integrador) mantiene responsabilidades críticas: validar compatibilidad, asegurar que el diseño cumpla requisitos del sitio y confirmar que el sistema opera bajo las condiciones reales. En la práctica, una buena relación contractual y técnica define:
Para que la colaboración funcione, es importante definir desde el inicio qué significa “soporte”. Por ejemplo, ¿el proveedor corrige bugs en lógica del comandante híbrido o solo brinda recomendaciones? ¿El proveedor ayuda a interpretar logs o provee herramientas de diagnóstico? ¿Hay acceso a entornos de preproducción o labs para reproducir incidentes?
Desde el punto de vista del cliente, hay responsabilidad indelegable: asegurar el encaje del sistema híbrido con requisitos del proceso y con reglas de seguridad del sitio. Eso implica validar:
Un aspecto que suele generar fricción es la gestión de versiones. En sistemas híbridos, las capas pueden actualizarse en momentos distintos. Por ejemplo, supervisión y automatización podrían tener ciclos de release diferentes. Si el comandante híbrido depende de contratos de interfaz, la actualización de una capa puede romper semánticas o introducir cambios en formatos de eventos. Mitigar exige un proceso de versionado que incluya:
También es clave establecer el “circuito de aprobación” para cambios. En un comandante híbrido, un cambio de configuración no es solo una actualización; puede alterar condiciones de transición y, por lo tanto, el comportamiento del sistema ante incidentes. El proceso debe estar gobernado: quién solicita, quién aprueba, quién verifica y cómo se registra.
Cuando se habla de sistemas de control y seguridad, es común apoyar la toma de decisiones con marcos de referencia de entidades reconocidas. Para la gestión de riesgos, continuidad y seguridad de la operación, suelen usarse estándares y guías publicadas por organismos técnicos. Entre las familias de referencias más utilizadas están guías de seguridad y buenas prácticas para sistemas de control industrial y gestión de riesgos. Si tu organización opera bajo normas específicas (por ejemplo, de seguridad de la información o de gestión), conviene alinear el diseño de Commander Hibrido con esos marcos y documentar las justificaciones técnicas.
En el contexto de Commander Hibrido, una buena práctica es trazar los requisitos del sistema hacia controles de seguridad y hacia prácticas de ingeniería. Es decir, en lugar de limitarse a decir “tenemos seguridad”, puedes mostrar “qué control cumple qué requisito”. Por ejemplo:
La idea es usar referencias para construir un lenguaje común entre ingeniería, operación y seguridad. Eso reduce la probabilidad de que “seguridad” sea un concepto vago. Además, ayuda a que los procesos de auditoría sean más rápidos, porque el equipo ya tiene documentación alineada.
Nota: esta guía evita cifras no verificadas. Si tu proyecto requiere métricas concretas (p. ej., disponibilidad objetivo, tiempos de recuperación o niveles de riesgo), deben calcularse con base en datos de tu instalación y pruebas de aceptación, y/o con informes oficiales del sector aplicables a tu industria.
Para complementar, considera que algunas organizaciones trabajan con modelos de riesgo que combinan probabilidad e impacto. En ese caso, Commander Hibrido debe evaluarse como componente de alto impacto (por su rol de coordinación), lo que suele traducirse en exigencias mayores de auditoría, pruebas de regresión y plan de respuesta. La mitigación no siempre es “más hardware”; a menudo es una mejor definición de estados, contratos de interfaces y observabilidad.
Finalmente, las referencias técnicas ayudan a evitar sesgos. Por ejemplo, un equipo podría centrarse en latencia y descuidar seguridad. O podría centrarse en seguridad de red y descuidar seguridad operacional (quién puede cambiar configuración y con qué evidencias). Usar marcos de referencia te permite recordar que el sistema híbrido se evalúa integralmente.
En términos prácticos, Commander Hibrido se entiende como una capa coordinadora de control que integra enfoques y capas (supervisión, automatización y comunicaciones) para unificar el mando. Su valor depende de la integración real, el modelo de estados y la forma en que gestiona seguridad, diagnósticos y fallos.
Una forma práctica de identificar si un comandante realmente es “híbrido” es comprobar si existe coordinación explícita entre capas con semántica clara. Por ejemplo: no basta con que exista una interfaz de automatización y otra de supervisión; debe existir una lógica de coordinación que decida cómo se conectan los estados, cómo se registran decisiones y cómo se maneja la incertidumbre.
La compatibilidad se verifica en la práctica con un levantamiento de interfaces (señales, protocolos, formatos, periodicidad) y pruebas de integración. Un análisis solo conceptual suele ser insuficiente: pide evidencias de funcionamiento bajo condiciones de operación realista y escenarios de fallo.
Si deseas una checklist operativa de compatibilidad, puedes considerar:
Los riesgos más comunes incluyen desalineación de estados entre subsistemas, fallas de comunicación no contempladas, falta de trazabilidad de decisiones y permisos insuficientes. Por eso se recomiendan pruebas con criterios verificables y un plan de respuesta ante incidentes.
Para priorizar, se puede usar una matriz riesgo: probabilidad vs impacto. En muchos casos, la desalineación de estados y la falta de trazabilidad elevan el impacto porque dificultan detectar y corregir a tiempo. La falla de comunicación no contemplada también se vuelve crítica cuando el sistema toma decisiones sin información actualizada.
Sí, especialmente cuando Commander Hibrido coordina acciones críticas. Los registros permiten reconstruir secuencias, justificar decisiones operativas, detectar anomalías y topar el proceso con base en evidencias.
La auditoría “detallada” no significa registrar todo con volumen infinito, sino registrar lo necesario con estructura y correlación. Un registro bien diseñado suele incluir campos consistentes: identificador de comando, usuario/rol, estado origen y destino, resultado, motivo de rechazo/timeout y timestamps.
En general, son indispensables: integración extremo a extremo (comando → ejecución → confirmación), pruebas de fallos (time/out, pérdida parcial de comunicación, entradas inválidas) y verificación de diagnósticos y auditoría. Las pruebas deben documentarse y compararse con criterios de aceptación definidos.
Como complemento, puedes incluir pruebas de:
Normalmente el proveedor apoya con documentación, configuración de referencia y soporte. No obstante, el cliente o integrador debe asegurar compatibilidad, validar requisitos del sitio y aprobar aceptación final con evidencias. La distribución de responsabilidades debe quedar clara desde el diseño.
Si quieres evitar vacíos, es útil que las responsabilidades estén descritas en un RACI (Responsible, Accountable, Consulted, Informed) o equivalente. Así, si ocurre un incidente, no se pierde tiempo discutiendo “quién debía resolver qué”.
Significa que, ante fallos parciales, el sistema no entra en comportamientos impredecibles. En lugar de ello, pasa a un estado seguro definido (o a un modo limitado) y registra el evento, permitiendo diagnóstico y recuperación conforme a procedimientos establecidos.
Ejemplo conceptual: si el sistema pierde la capacidad de confirmar una acción, podría no seguir ejecutando nuevas acciones dependientes. En lugar de eso, entra a un modo donde solo permite tareas no críticas o espera reintentos, y si no se recupera dentro del tiempo, activa un procedimiento de seguridad o solicita intervención.
El objetivo de esta pieza es ofrecer un marco técnico y operativo para Commander Hibrido. Si necesitas que el contenido incluya datos de precio y detalles de proveedor con una región específica, compárteme esa información (o parámetros) para integrarla en el texto sin comprometer precisión.
En el caso de precios y selección de proveedor, el criterio técnico sigue siendo central. El precio por sí solo no garantiza que el comandante híbrido tenga observabilidad, seguridad por diseño y pruebas adecuadas. Si en tu proceso de compra necesitas comparar alternativas, conviene pedir evidencias de pruebas, matrices de compatibilidad y documentación de manejo de fallos.
La diferencia entre “implementar un sistema” y “obtener una topa operativa” está en el rigor con el que se diseñan los estados, se valida la compatibilidad, se asegura la trazabilidad y se preparan procedimientos ante fallos. Commander Hibrido puede ser una base sólida si se aborda como un sistema de ingeniería: con pruebas verificables, seguridad por diseño, diagnóstico útil y gobernanza de cambios. Si sigues el itinerario paso a paso y exiges condiciones claras antes de producción, es mucho más probable que el proyecto resulte estable, mantenible y comprensible para quienes lo operan.
Para que Commander Hibrido se convierta en ventaja operativa, además de lo anterior, conviene medir y mejorar continuamente. En operación, implementa un ciclo de mejora basado en incidentes y desempeño. Por ejemplo, cuando ocurre un rechazo de comando, registra la causa, revisa si el diagnóstico fue accionable y evalúa si el modelo de estados o los contratos de interfaz necesitan ajuste. Cuando se detecta degradación, revisa métricas y revisa si el sistema se comportó según el plan. Esa mejora continua evita que el comandante se convierta en una “caja negra” difícil de sostener.
También es recomendable establecer una cultura de documentación viva. No basta con entregar manuales al inicio: los manuales deben actualizarse con lo aprendido. Si el sistema introduce nuevos estados o procedimientos, el equipo operativo debe contar con guías claras para cada escenario típico. De lo contrario, el valor del comandante híbrido se pierde por falta de adopción.
Finalmente, recuerda que el objetivo del enfoque híbrido es coordinación y reducción de ambigüedad operativa. Si el sistema está bien diseñado, debe disminuir incertidumbre: el operador debe entender qué pasa, por qué pasó y qué hacer después. Ese es el criterio último de éxito. Cuando Commander Hibrido cumple ese estándar, no solo coordina subsistemas; coordina decisiones humanas y técnicas alrededor de un marco común, elevando la confiabilidad del proceso y la gobernanza de la operación.



Esta guía explica cómo evaluar e implementar Commander Hibrido en entornos de control híbrido, con enfoque en criterios técnicos, riesgos y buenas prácticas operativas. El texto contextualiza, de forma objetiva, qué implica “híbrido” en mandos y comunicaciones, cómo se integra con sistemas existentes y qué requisitos suelen pedir los equipos de ingeniería para asegurar compatibilidad, seguridad y trazabilidad.
El Gac Hibrido combina motorización y gestión electrónica para optimizar el consumo y el uso diario. Este guía describe, de forma objetiva, qué significa un sistema híbrido en términos técnicos, cómo se integra en la conducción cotidiana y qué factores conviene comparar al evaluar opciones disponibles en el mercado. Además, incluye condiciones de selección y un apartado de preguntas frecuentes.
Esta guía explica qué es el Gac Hibrido y cómo se evalúa su desempeño técnico y compatibilidad antes de integrarlo en un proceso productivo. Se revisa, de forma objetiva, el trasfondo del concepto “híbrido” aplicado a componentes industriales, los criterios de calidad habituales y el rol del proveedor. Finalmente, se incluyen condiciones de compra y respuestas a preguntas frecuentes para orientar decisiones.
El Commander Hibrido integra componentes y decisiones en un enfoque híbrido para topar la coordinación, la trazabilidad y la eficiencia operativa. Este artículo explica, de manera objetiva, qué significa “híbrido” en el contexto de mando y control, por qué se adopta en organizaciones técnicas y cómo evaluar su implementación sin suposiciones ni métricas no verificadas.
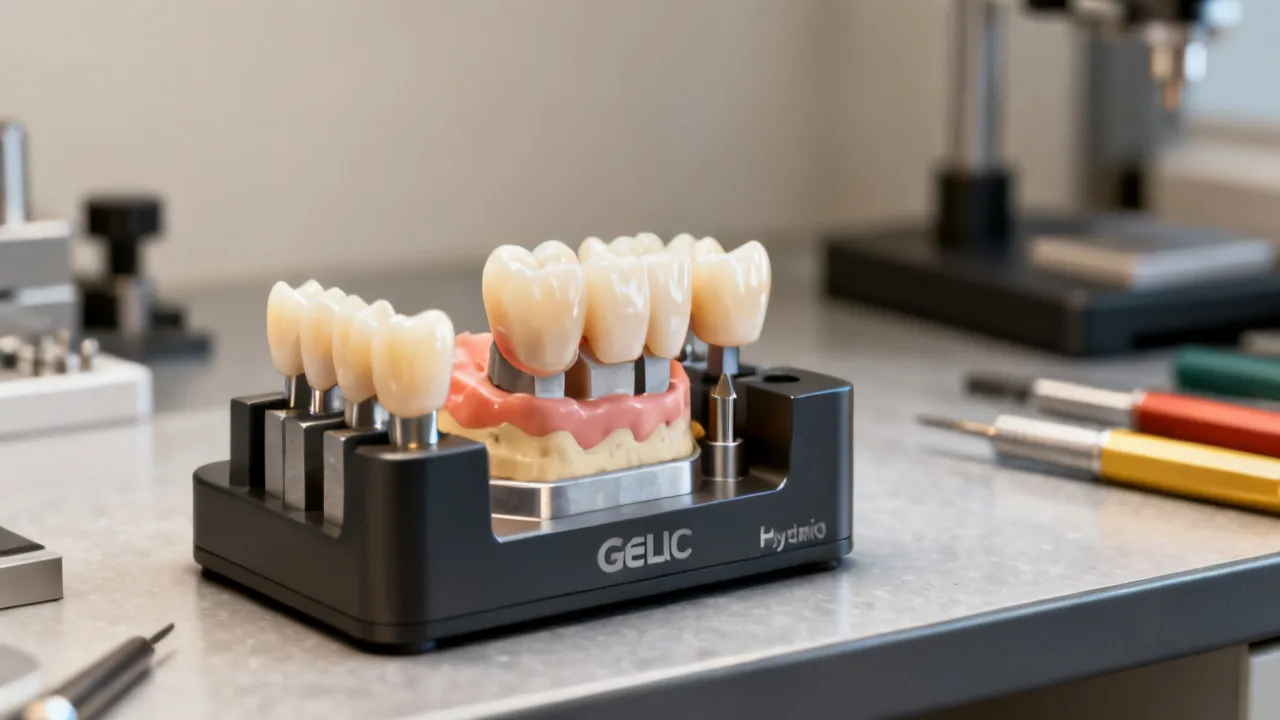
El Gac Hibrido es una solución dental de enfoque mixto que combina criterios de rendimiento y durabilidad para restauraciones. Este artículo explica, de forma objetiva, qué significa el concepto “Gac Hibrido”, cómo se evalúan sus propiedades en laboratorio y clínica, y qué consideraciones deben priorizarse al elegir proveedor, proceso y compatibilidad con tu caso.
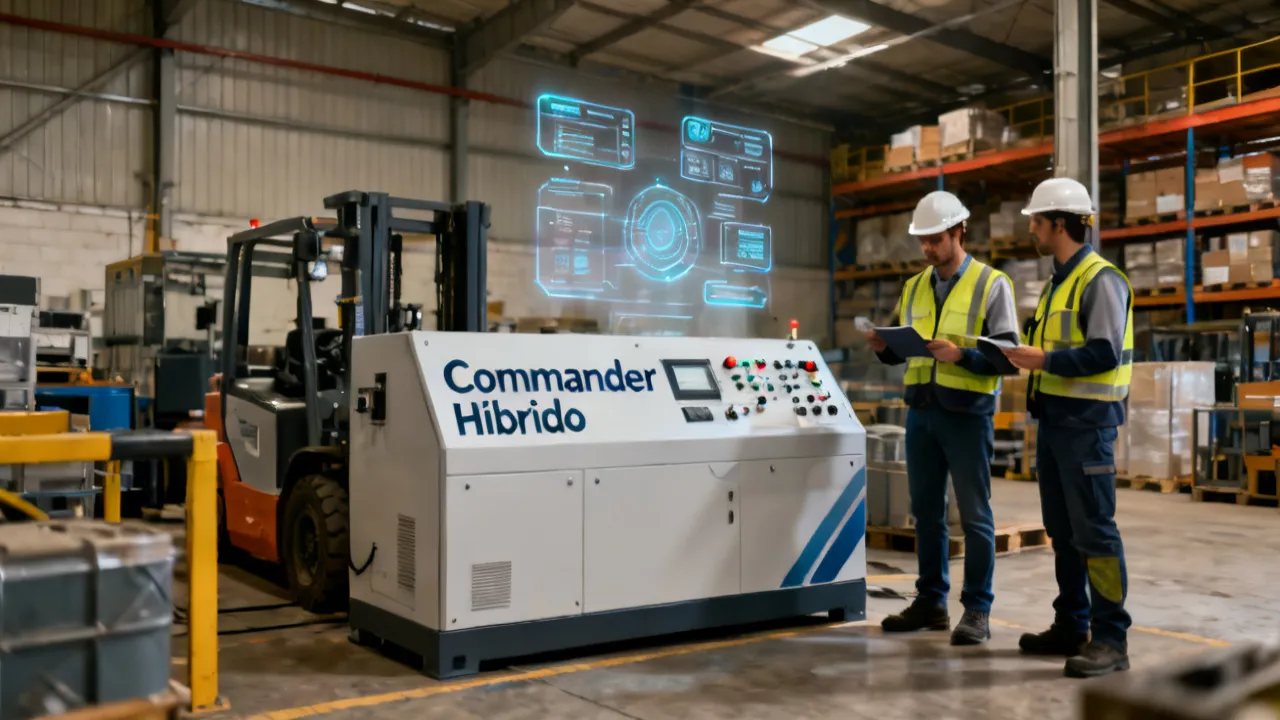
Este artículo explica, de forma objetiva, cómo evaluar e integrar un “Commander Hibrido” en entornos industriales, considerando compatibilidad, diseño de arquitectura, seguridad operativa y criterios de selección. Se contextualizan los conceptos clave del mando híbrido, sus aplicaciones típicas en sistemas de control y los requisitos habituales de puesta en marcha, desde la verificación técnica hasta la documentación.

